Index bloat do bộ lọc xảy ra khi hệ thống facet tạo ra nhiều biến thể URL hơn mức cần thiết, khiến công cụ tìm kiếm phải phát hiện, thu thập dữ liệu hoặc lập chỉ mục những trang ít giá trị. Vấn đề thường xuất hiện trên website thương mại điện tử, danh mục bất động sản, tuyển dụng, du lịch và các hệ thống có nhiều thuộc tính lọc.
Không nên kết luận website bị index bloat chỉ vì nhìn thấy nhiều URL tham số. Trước khi xử lý, cần xác định từng mẫu URL đang ở trạng thái được phát hiện, đã crawl hay thực sự được index. Mỗi trạng thái đòi hỏi một biện pháp khác nhau.
Index bloat do bộ lọc là gì?
Bộ lọc giúp người dùng thu hẹp danh sách theo màu sắc, kích thước, thương hiệu, mức giá, khu vực hoặc những thuộc tính khác. Tuy nhiên, nếu mỗi lựa chọn và thứ tự lựa chọn đều tạo URL mới, số lượng địa chỉ có thể tăng nhanh.
Ví dụ, cùng một tập sản phẩm có thể được truy cập qua nhiều URL:
/ao?mau=do&size=m/ao?size=m&mau=do/ao?mau=do&size=m&sort=gia-tang/ao?mau=do&size=m&utm_source=email
Các URL này không nhất thiết đều là lỗi. Một trang lọc có nhu cầu tìm kiếm rõ ràng, tập sản phẩm phù hợp và nội dung khác biệt có thể là landing page hữu ích. Ngược lại, URL chỉ thay đổi thứ tự sắp xếp, tham số theo dõi hoặc tạo danh sách gần như trùng lặp thường không cần được index.
Nếu chưa xác định vai trò của từng thuộc tính, nên bắt đầu từ cách phân loại facet và URL bộ lọc cho SEO thay vì áp dụng một quy tắc chung cho toàn bộ tham số.
Dấu hiệu cần điều tra gồm:
- Số URL trong báo cáo lập chỉ mục lớn hơn nhiều so với số trang danh mục và sản phẩm dự kiến.
- Google phát hiện nhiều URL có tham số nhưng không index.
- Nhật ký máy chủ ghi nhận bot liên tục truy cập các tổ hợp lọc sâu.
- Kết quả tìm kiếm xuất hiện nhiều trang lọc gần giống nhau.
- URL bộ lọc nhận lượt hiển thị nhưng truy vấn không phù hợp hoặc cạnh tranh với trang danh mục chính.
- Sitemap chỉ chứa URL chuẩn nhưng báo cáo vẫn ghi nhận lượng lớn URL tham số.
Toán tử site: có thể hỗ trợ xem nhanh ví dụ URL xuất hiện trên kết quả tìm kiếm, nhưng không phải công cụ đếm toàn bộ chỉ mục. Không nên dùng số kết quả ước tính từ toán tử này làm bằng chứng duy nhất về index bloat.
Phân biệt URL được phát hiện, đã crawl và đã index
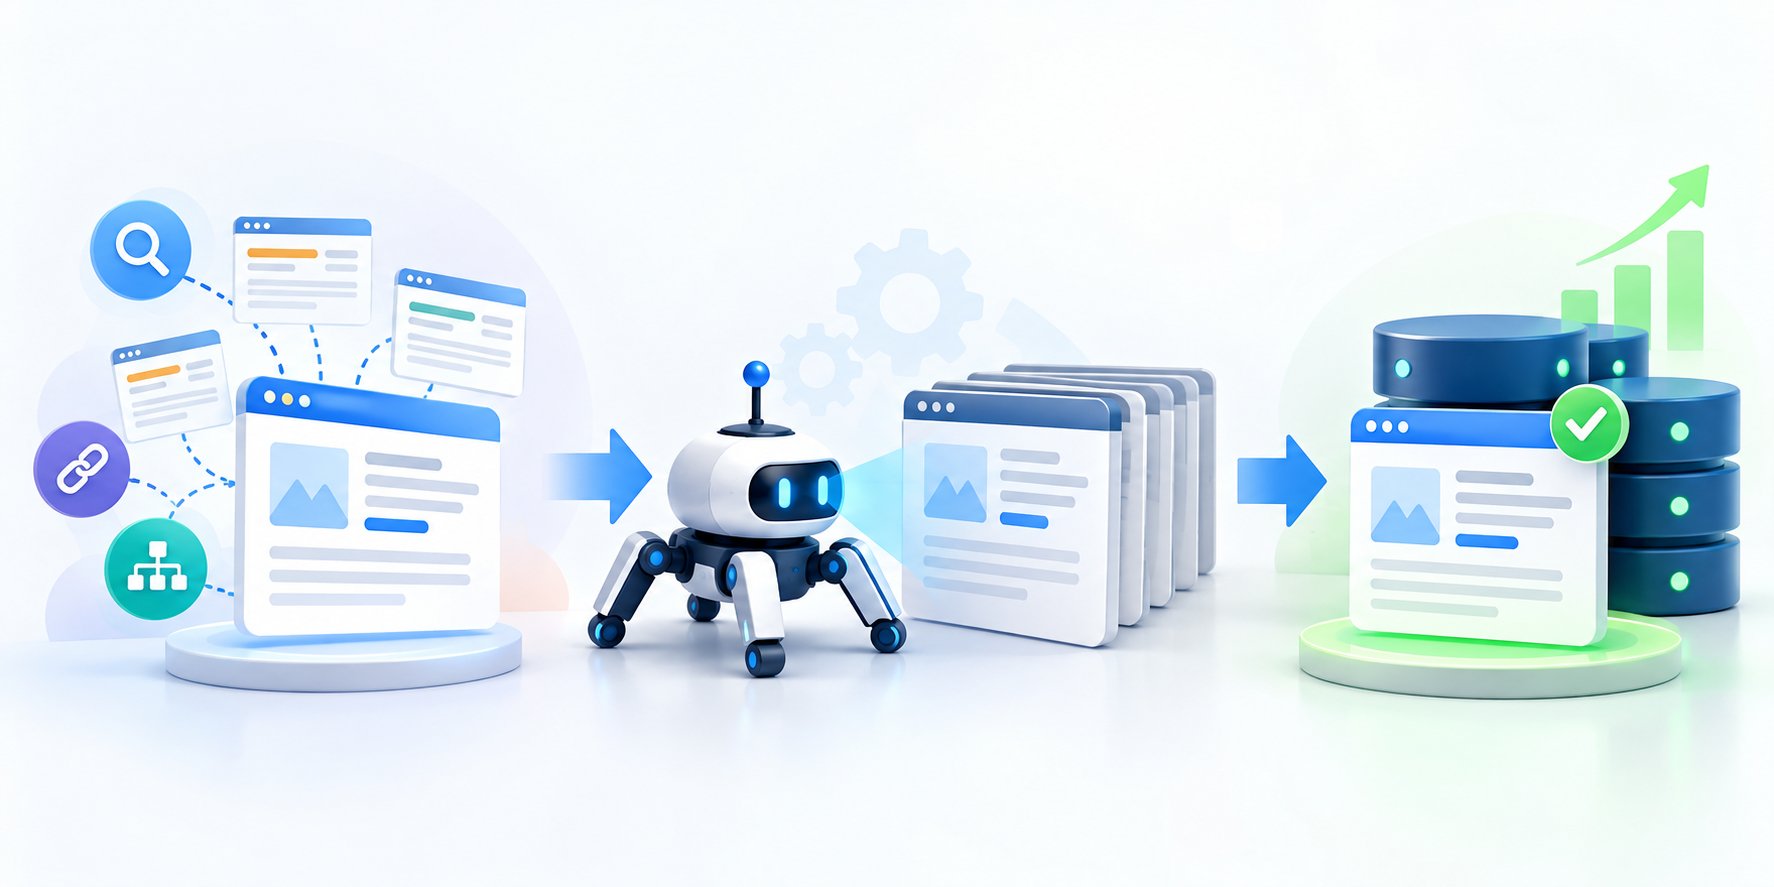
Ba trạng thái sau thường bị nhầm lẫn:
| Trạng thái | Ý nghĩa | Dữ liệu nên kiểm tra | Hướng xử lý chính |
|---|---|---|---|
| Được phát hiện | Công cụ tìm kiếm biết URL tồn tại từ liên kết, sitemap, dữ liệu cũ hoặc nguồn khác nhưng có thể chưa truy cập | Báo cáo lập chỉ mục, sitemap, liên kết nội bộ và dữ liệu crawl | Giảm nguồn tạo URL và kiểm soát khả năng khám phá |
| Đã crawl | Bot đã gửi yêu cầu và nhận phản hồi từ URL | Nhật ký máy chủ, dữ liệu crawl, kiểm tra URL | Cải thiện phản hồi, canonical, noindex hoặc loại bỏ URL tùy mục đích |
| Đã index | URL đã được đưa vào chỉ mục và có khả năng xuất hiện trên kết quả tìm kiếm | Báo cáo lập chỉ mục, kiểm tra URL, dữ liệu hiệu suất tìm kiếm | Quyết định giữ index, hợp nhất hoặc loại khỏi chỉ mục |
Một URL được phát hiện chưa chắc đã được crawl. URL đã crawl cũng chưa chắc được index. Ngược lại, URL từng được index có thể vẫn được ghi nhận trong dữ liệu lịch sử dù hiện tại đã thay đổi trạng thái.
Sự phân biệt này ảnh hưởng trực tiếp đến lựa chọn kỹ thuật:
- Chặn crawl không đồng nghĩa với xóa URL khỏi chỉ mục.
noindexchỉ có thể được xử lý khi bot truy cập và đọc được chỉ thị.- Canonical là tín hiệu hợp nhất, không phải mệnh lệnh tuyệt đối.
- Xóa URL khỏi sitemap chỉ làm giảm một nguồn khám phá, không ngăn URL được tìm thấy qua liên kết nội bộ.
nofollowtrên liên kết không bảo đảm URL sẽ không được phát hiện hoặc index.
Dữ liệu cần kết hợp để kiểm tra faceted navigation
Không có một báo cáo đơn lẻ nào phản ánh đầy đủ toàn bộ hệ thống URL bộ lọc. Cần ghép ít nhất bốn nhóm dữ liệu sau.
Báo cáo lập chỉ mục
Báo cáo lập chỉ mục cho biết Google đang ghi nhận những nhóm URL nào, lý do URL không được index và xu hướng thay đổi theo thời gian. Khi phân tích, hãy xuất các URL ví dụ rồi nhóm theo mẫu thay vì xử lý từng địa chỉ riêng lẻ.
Các mẫu nên nhận diện gồm:
- Tên tham số như
color,size,brand,sort,pagehoặc tham số theo dõi. - Số lượng tham số trên một URL.
- Thứ tự tham số khác nhau nhưng nội dung giống nhau.
- Đường dẫn lọc được viết lại thành thư mục.
- Tổ hợp trả về danh sách rỗng hoặc rất ít lựa chọn.
- URL có canonical về trang khác.
- URL bị chuyển hướng, lỗi mềm, 404 hoặc có chỉ thị
noindex.
Kiểm tra URL riêng lẻ có thể xác nhận canonical do website khai báo, canonical được Google lựa chọn, khả năng crawl và trạng thái index. Tuy nhiên, vài URL mẫu không đại diện cho toàn bộ hệ thống, nên cần chọn mẫu ở nhiều cấp độ lọc.
Truy vấn và trang đích từ tìm kiếm
Dữ liệu hiệu suất tìm kiếm giúp trả lời hai câu hỏi: URL lọc có đang xuất hiện hay không, và nó xuất hiện cho nhu cầu nào.
Hãy đối chiếu:
- Truy vấn với trang đích tương ứng.
- Nhiều URL lọc cùng xuất hiện cho một nhóm truy vấn.
- Trang lọc cạnh tranh với danh mục chính.
- URL có lượt hiển thị nhưng nội dung không đáp ứng đúng nhu cầu.
- Trang lọc nhận truy vấn cụ thể mà danh mục tổng quát không đáp ứng tốt.
Báo cáo truy vấn không phải danh sách đầy đủ mọi URL đã index. URL không có lượt hiển thị vẫn có thể nằm trong chỉ mục. Dữ liệu này chủ yếu giúp nhận diện giá trị tìm kiếm và nguy cơ trùng ý định. Việc xác định search intent từ kết quả tìm kiếm nên được thực hiện trước khi quyết định giữ lại một trang facet làm landing page SEO.
Sitemap XML
Sitemap nên phản ánh những URL chuẩn mà website thực sự muốn được index. Khi kiểm tra sitemap, cần tìm:
- URL tham số vô tình được đưa vào sitemap.
- Trang lọc có
noindexnhưng vẫn nằm trong sitemap. - URL chuyển hướng hoặc canonical sang địa chỉ khác.
- Phiên bản URL không nhất quán về giao thức, tên miền, dấu gạch chéo hoặc chữ hoa và chữ thường.
- Trang lọc chiến lược không có trong sitemap dù đủ điều kiện index.
Nếu một URL không có trong sitemap, điều đó không có nghĩa Google không thể tìm thấy URL. Liên kết điều hướng, liên kết trong mã HTML, đường dẫn do JavaScript tạo, nguồn bên ngoài và dữ liệu crawl trước đây vẫn có thể làm URL được phát hiện.
Dữ liệu crawl và nhật ký máy chủ
Một trình crawl cho biết website đang tạo và liên kết tới những URL nào. Nhật ký máy chủ cho biết bot thực sự yêu cầu URL nào. Hai nguồn này bổ sung cho nhau:
- Crawl nội bộ phát hiện nguồn liên kết và độ sâu của URL bộ lọc.
- Nhật ký máy chủ xác nhận tần suất truy cập, mã phản hồi và mẫu URL được bot ưu tiên.
- So sánh hai nguồn giúp tìm URL được bot truy cập dù không còn liên kết rõ ràng trên giao diện.
- Dữ liệu phản hồi giúp phát hiện chuỗi chuyển hướng, lỗi máy chủ và trang lọc rỗng trả về mã 200.
Khi website có không gian URL lớn, việc tối ưu ngân sách crawl nên tập trung trước vào nguyên nhân tạo URL vô hạn hoặc lặp lại, thay vì chỉ chặn từng tham số đã thấy.
Quy trình tìm mẫu URL bộ lọc phát sinh quá mức
Bước 1: Lập danh mục tất cả cơ chế tạo URL
Kiểm tra giao diện danh mục, biểu mẫu lọc, liên kết phân trang, sắp xếp, đổi chế độ hiển thị và tham số theo dõi. Ghi nhận với mỗi cơ chế:
- Tên tham số hoặc cấu trúc đường dẫn.
- Giá trị có thể kết hợp.
- URL có được liên kết bằng thẻ liên kết HTML hay không.
- Lựa chọn có làm thay đổi tập sản phẩm hay chỉ thay đổi cách trình bày.
- Có thể chọn nhiều giá trị của cùng một thuộc tính hay không.
- Hệ thống có tạo URL mới khi đổi thứ tự lựa chọn hay không.
Mục tiêu của bước này là hiểu quy tắc sinh URL, không phải thu thập mọi tổ hợp có thể tồn tại.
Bước 2: Chuẩn hóa URL trước khi nhóm
Dữ liệu từ nhiều nguồn cần được chuẩn hóa để tránh đếm cùng một ý nghĩa thành nhiều nhóm. Có thể tách URL thành các trường:
- Giao thức và tên miền.
- Đường dẫn danh mục.
- Tên tham số.
- Giá trị tham số.
- Số tham số.
- Thứ tự tham số.
- Mã phản hồi.
- Chỉ thị index.
- Canonical khai báo.
- Nguồn phát hiện.
Không nên xóa tham số khỏi tập dữ liệu gốc. Hãy giữ URL nguyên bản và tạo thêm phiên bản chuẩn hóa để so sánh.
Bước 3: Nhóm URL theo mẫu thay vì theo từng địa chỉ
Một số nhóm thực tế có thể là:
- Chỉ có tham số sắp xếp.
- Chỉ có tham số theo dõi.
- Một thuộc tính lọc có nhu cầu tìm kiếm.
- Nhiều thuộc tính lọc kết hợp.
- Cùng bộ tham số nhưng khác thứ tự.
- Bộ lọc tạo danh sách rỗng.
- Phân trang bên trong một tổ hợp lọc.
- URL chứa giá trị không hợp lệ hoặc lặp giá trị.
Với mỗi nhóm, lấy mẫu ở trang đầu, trang sâu, tổ hợp phổ biến và tổ hợp hiếm. Sau đó đối chiếu trạng thái phát hiện, crawl và index.
Bước 4: Ghép các nguồn dữ liệu
Bảng làm việc nên có tối thiểu các cột sau:
| Trường dữ liệu | Mục đích |
|---|---|
| URL gốc | Đối chiếu chính xác địa chỉ |
| Mẫu URL | Gom các URL cùng cơ chế phát sinh |
| Nguồn phát hiện | Xác định sitemap, liên kết nội bộ hay nguồn khác |
| Trạng thái crawl | Biết bot đã truy cập hay chưa |
| Mã phản hồi | Phát hiện URL lỗi, chuyển hướng hoặc trả về 200 |
| Trạng thái index | Tách URL được phát hiện khỏi URL đã index |
| Canonical | Kiểm tra tín hiệu hợp nhất |
| Chỉ thị robots | Xác định khả năng index và crawl |
| Truy vấn hoặc lượt hiển thị | Đánh giá giá trị tìm kiếm nếu có dữ liệu |
| Số sản phẩm hoặc kết quả | Phát hiện trang rỗng và tổ hợp quá hẹp |
| Có trong sitemap | Kiểm tra sự nhất quán với mục tiêu index |
Nếu không thể ghép dữ liệu cho mọi URL, hãy ưu tiên theo mẫu và lấy mẫu đại diện. Không nên coi tập URL xuất từ một báo cáo là toàn bộ không gian URL của website.
Bước 5: Xác định tác động và mức ưu tiên
Ưu tiên cao thường thuộc về các mẫu URL có nhiều yếu tố cùng lúc:
- Được tạo với quy mô lớn.
- Có liên kết nội bộ khiến bot dễ dàng tiếp tục khám phá.
- Được crawl thường xuyên nhưng không mang lại giá trị tìm kiếm.
- Tạo nội dung trùng hoặc gần trùng với danh mục chính.
- Gây ra nhiều URL rỗng, lỗi mềm hoặc chuỗi chuyển hướng.
- Làm trang quan trọng khó được crawl hoặc cập nhật kịp thời.
Không cần gán một ngưỡng cố định cho mọi website. Quy mô danh mục, tốc độ thay đổi sản phẩm, năng lực máy chủ và nhu cầu tìm kiếm của từng ngành khác nhau.
Chọn biện pháp xử lý theo từng nhóm URL
Giữ index đối với trang lọc có giá trị độc lập
Một trang lọc có thể được giữ lại khi đáp ứng nhu cầu tìm kiếm riêng, có tập kết quả ổn định và cung cấp giá trị khác với danh mục tổng quát. Trang nên có:
- URL ổn định, dễ hiểu và không phụ thuộc thứ tự chọn bộ lọc.
- Tiêu đề, nội dung chính và liên kết nội bộ phù hợp với ý định.
- Canonical trỏ về chính nó.
- Mã phản hồi thành công.
- Sản phẩm hoặc kết quả đủ phù hợp với nhu cầu.
- Không có chỉ thị ngăn index.
- Có mặt trong sitemap nếu đây là landing page SEO chủ đích.
Nên áp dụng tiêu chí quyết định index trang lọc sản phẩm cho từng nhóm nhu cầu, thay vì index tự động mọi tổ hợp có sản phẩm.
Dùng canonical khi URL là biến thể tương đương
Canonical phù hợp khi nhiều URL vẫn cần tồn tại cho người dùng nhưng có nội dung tương đương hoặc rất gần nhau, chẳng hạn tham số sắp xếp hay theo dõi. Canonical cần nhất quán với liên kết nội bộ và sitemap.
Không nên canonical mọi trang lọc về danh mục gốc nếu tập sản phẩm và ý định khác biệt đáng kể. Khi tín hiệu mâu thuẫn, công cụ tìm kiếm có thể chọn canonical khác với URL website khai báo.
Dùng noindex khi URL cần hoạt động nhưng không nên xuất hiện trên tìm kiếm
noindex phù hợp với trang người dùng vẫn cần truy cập nhưng không có giá trị tìm kiếm độc lập, chẳng hạn một số tổ hợp quá hẹp hoặc kết quả tìm kiếm nội bộ.
URL phải được phép crawl đủ để bot đọc chỉ thị. Nếu đồng thời chặn URL trong tệp robots, bot có thể không nhìn thấy noindex. Sau khi URL đã được loại khỏi chỉ mục, website mới nên cân nhắc việc hạn chế crawl nếu thực sự cần thiết.
Loại bỏ nguồn tạo URL không có chức năng
Với tham số theo dõi, giá trị lặp, thứ tự tham số tùy ý hoặc URL được tạo do lỗi kỹ thuật, giải pháp bền vững là sửa cơ chế sinh liên kết:
- Không đưa tham số không cần thiết vào liên kết nội bộ.
- Chuẩn hóa thứ tự tham số.
- Ngăn chọn lặp cùng một giá trị.
- Không tạo liên kết cho tổ hợp không có kết quả.
- Dùng một URL duy nhất cho cùng trạng thái nội dung.
- Chuyển hướng chỉ khi URL cũ và URL đích thực sự tương đương.
Trả về 404 hoặc 410 cho URL không còn hợp lệ
URL không đại diện cho nội dung hoặc chức năng hợp lệ có thể trả về 404 hay 410. Không nên chuyển mọi URL lọc lỗi về trang danh mục hoặc trang chủ, vì cách này có thể tạo trải nghiệm không phù hợp và làm tín hiệu URL khó hiểu hơn.
Dùng robots.txt để kiểm soát crawl một cách thận trọng
Chặn mẫu URL trong robots.txt có thể giảm việc crawl, nhưng không phải biện pháp trực tiếp để xóa URL đã index. Quy tắc quá rộng còn có thể chặn nhầm trang cần index hoặc ngăn bot đọc canonical và noindex.
Trước khi triển khai, cần kiểm tra mẫu tham số, thứ tự tham số, URL được mã hóa và các đường dẫn hợp lệ có thể trùng quy tắc. Đây thường là bước sau khi đã sửa nguồn phát sinh và giải quyết trạng thái index, không phải bước đầu tiên.
Thứ tự triển khai để tránh làm mất trang có giá trị
Một trình tự an toàn hơn là:
- Sao lưu dữ liệu về URL, truy vấn, canonical, trạng thái index và nguồn liên kết.
- Phân loại trang lọc cần giữ index dựa trên nhu cầu tìm kiếm và giá trị nội dung.
- Tạo danh sách mẫu URL cần hợp nhất, noindex, loại bỏ hoặc hạn chế crawl.
- Sửa cơ chế tạo liên kết và chuẩn hóa URL trước.
- Làm sạch sitemap để chỉ giữ URL chuẩn đủ điều kiện index.
- Triển khai canonical,
noindex, chuyển hướng hoặc mã lỗi đúng với từng nhóm. - Chỉ cân nhắc chặn crawl sau khi chắc chắn bot không còn cần truy cập để đọc tín hiệu loại khỏi chỉ mục.
- Crawl lại website và kiểm tra một số URL đại diện trước khi mở rộng thay đổi.
Không nên thay đổi canonical, noindex, robots.txt và cấu trúc URL cùng lúc trên toàn bộ website nếu chưa thử nghiệm. Khi nhiều tín hiệu thay đổi đồng thời, việc xác định nguyên nhân nếu lưu lượng hoặc trạng thái index biến động sẽ khó hơn.
Cách theo dõi kết quả sau khi xử lý
Hiệu quả không chỉ được đánh giá bằng việc tổng số URL giảm. Cần theo dõi đồng thời:
- Số URL bộ lọc được phát hiện, đã crawl và đã index theo từng mẫu.
- Tần suất bot truy cập các mẫu URL không mong muốn trong nhật ký máy chủ.
- Tỷ lệ URL sitemap được index và tính nhất quán của canonical.
- Lượt hiển thị của trang danh mục và trang lọc chiến lược.
- Hiện tượng nhiều URL cạnh tranh cho cùng nhóm truy vấn.
- Mã phản hồi của URL cũ sau khi loại bỏ hoặc chuyển hướng.
- Khả năng crawl và index của sản phẩm, danh mục quan trọng.
Hãy kiểm tra URL đại diện cho từng quy tắc, gồm URL còn được index, URL cần noindex, URL canonical, URL bị loại bỏ và trang lọc chiến lược. Nếu trang quan trọng vô tình biến mất, quy trình kiểm tra nguyên nhân website không được index có thể giúp rà soát lại chỉ thị robots, canonical, mã phản hồi và khả năng khám phá.
Index bloat do bộ lọc là vấn đề về hệ thống tạo URL và tín hiệu lập chỉ mục, không chỉ là số lượng trang. Cách xử lý đáng tin cậy nhất là kết hợp báo cáo lập chỉ mục, truy vấn tìm kiếm, sitemap, dữ liệu crawl và nhật ký máy chủ; sau đó phân loại rõ URL được phát hiện, đã crawl và đã index trước khi chọn giải pháp.