Trang mồ côi là gì?
Trang mồ côi, hay orphan page, là URL tồn tại trên website nhưng không nhận được liên kết nội bộ có thể thu thập từ các trang khác trong cấu trúc website. Người dùng và trình thu thập dữ liệu đi từ trang chủ, menu, danh mục hoặc bài viết liên quan sẽ khó tìm thấy URL này bằng cách nhấp liên kết thông thường.
Một trang thường được xem là mồ côi khi đáp ứng đồng thời hai điều kiện:
- URL vẫn tồn tại hoặc từng tồn tại trong hệ thống.
- Quá trình crawl từ các điểm bắt đầu hợp lệ không phát hiện liên kết nội bộ trỏ đến URL.
Trang mồ côi không đồng nghĩa với trang chưa được index. Một URL không có liên kết nội bộ vẫn có thể được công cụ tìm kiếm biết đến qua sitemap, liên kết ngoài, dữ liệu lịch sử hoặc lần crawl trước. Ngược lại, một trang có liên kết nội bộ vẫn có thể không được index vì nội dung, canonical, chỉ thị noindex, phản hồi máy chủ hoặc các vấn đề kỹ thuật khác.
Cũng cần phân biệt orphan page với trang có độ sâu liên kết lớn. Nếu URL vẫn nhận được liên kết nội bộ nhưng phải đi qua nhiều lớp mới tới được, đó là trang nằm sâu trong cấu trúc chứ chưa phải trang mồ côi.
Vì sao URL vẫn xuất hiện dù không có liên kết nội bộ?
URL có trong sitemap XML
Sitemap là danh sách URL được website cung cấp cho công cụ tìm kiếm, không phải sơ đồ điều hướng dành cho người dùng. Vì vậy, một trang có thể nằm trong sitemap nhưng hoàn toàn không được liên kết từ menu, danh mục, bài viết hoặc trang sản phẩm khác.
Sitemap giúp URL được phát hiện nhưng không thay thế vai trò của liên kết nội bộ. Nếu một trang quan trọng chỉ xuất hiện trong sitemap, cấu trúc website chưa thể hiện rõ mối quan hệ và mức độ ưu tiên của trang đó.
URL có dữ liệu trong GA4
GA4 có thể ghi nhận lượt truy cập vào một URL ngay cả khi URL không có liên kết nội bộ. Người dùng có thể đến trang qua:
- Kết quả tìm kiếm tự nhiên.
- Quảng cáo, email hoặc mạng xã hội.
- Liên kết từ website khác.
- Dấu trang hoặc URL được nhập trực tiếp.
- Một liên kết nội bộ đã bị xóa sau khi lượt truy cập được ghi nhận.
Do đó, có dữ liệu truy cập không chứng minh rằng URL đang được kết nối với cấu trúc website hiện tại. GA4 phản ánh hành vi truy cập trong khoảng thời gian được chọn, còn dữ liệu crawl phản ánh khả năng khám phá URL qua liên kết tại thời điểm kiểm tra.
URL xuất hiện trong Google Search Console
GSC có thể hiển thị URL trong báo cáo hiệu suất hoặc lập chỉ mục vì Google từng phát hiện trang qua sitemap, liên kết ngoài, chuyển hướng, dữ liệu lịch sử hoặc cấu trúc website cũ. Một URL từng có lượt hiển thị cũng có thể đã mất toàn bộ liên kết nội bộ sau khi website thay menu, danh mục hoặc mẫu giao diện.
Nếu URL xuất hiện trong GSC nhưng không có trong kết quả crawl, chưa nên kết luận ngay rằng công cụ crawl bị lỗi. Cần kiểm tra trạng thái URL hiện tại, canonical, chuyển hướng và nguồn phát hiện trước khi quyết định.
URL được tạo tự động hoặc còn sót lại sau thay đổi website
Các URL mồ côi thường phát sinh sau khi:
- Đổi cấu trúc danh mục hoặc điều hướng.
- Di chuyển nội dung nhưng không cập nhật toàn bộ liên kết.
- Xóa thẻ, danh mục hoặc trang tổng hợp.
- Xuất bản trang đích chỉ dùng cho một chiến dịch.
- Hệ thống tạo URL tham số, tìm kiếm hoặc bộ lọc.
- Thay mẫu giao diện làm mất khối bài viết liên quan.
Đặc biệt, URL tham số và bộ lọc có thể làm danh sách cần kiểm tra tăng nhanh. Trước khi thêm liên kết cho các URL này, nên hiểu rõ cách xử lý URL bộ lọc cho SEO để tránh đưa các tổ hợp ít giá trị vào cấu trúc website.
Cách tìm trang không có liên kết nội bộ
Không có một nguồn dữ liệu đơn lẻ nào cho danh sách đầy đủ. Cách đáng tin cậy hơn là tạo nhiều tập URL rồi đối chiếu chúng.
1. Crawl website từ các điểm bắt đầu hợp lệ
Bắt đầu crawl từ trang chủ và các trang điều hướng chính, cho phép trình thu thập đi theo liên kết nội bộ. Kết quả này đại diện cho tập URL có thể được khám phá qua cấu trúc liên kết hiện tại.
Khi cấu hình crawl, cần lưu ý:
- Phạm vi tên miền và giao thức có chính xác không.
- Trình thu thập có xử lý nội dung được tạo bằng JavaScript hay không.
- robots.txt, nofollow, yêu cầu đăng nhập hoặc tham số có giới hạn quá trình crawl không.
- Phiên bản URL có dấu gạch chéo, viết hoa, HTTP và HTTPS có bị tách riêng không.
- Crawl có kết thúc sớm do giới hạn tài nguyên hay không.
Một URL không xuất hiện trong lần crawl chưa chắc là trang mồ côi thật. Đó cũng có thể là URL nằm sau biểu mẫu, nội dung tải động, khu vực đăng nhập hoặc một liên kết bị hỏng. Việc tìm và sửa link hỏng trên website giúp loại trừ trường hợp đường dẫn vẫn được đặt trên trang nhưng không dẫn đúng đến URL đích.
2. Xuất danh sách URL trong sitemap
Thu thập URL từ tất cả sitemap đang được khai báo, bao gồm sitemap con nếu có. Sau đó chuẩn hóa URL trước khi so sánh: thống nhất giao thức, tên miền, dấu gạch chéo cuối, ký tự viết hoa và loại bỏ phần neo sau dấu thăng.
Nếu một URL có trong sitemap nhưng không có trong dữ liệu crawl, URL đó là ứng viên orphan page. Tuy nhiên, vẫn phải kiểm tra xem sitemap có đang chứa URL chuyển hướng, lỗi, noindex, canonical sang trang khác hoặc URL cũ hay không.
3. Lấy URL đích từ GA4
Trong GA4, sử dụng dữ liệu trang đích để xác định những URL từng là điểm vào phiên truy cập. Chọn khoảng thời gian đủ phù hợp với chu kỳ nội dung và hoạt động kinh doanh, sau đó xuất đường dẫn trang đích để so sánh với tập URL crawl.
Cần xử lý chuỗi truy vấn cẩn thận. Cùng một trang có thể xuất hiện dưới nhiều biến thể do tham số chiến dịch hoặc tham số theo dõi. Không nên tự động coi mỗi biến thể là một trang mồ côi riêng.
4. Xuất URL từ GSC
Từ báo cáo hiệu suất, lấy danh sách trang có lượt hiển thị hoặc lượt nhấp trong khoảng thời gian phù hợp. Kết hợp với dữ liệu lập chỉ mục và kiểm tra URL cho các trường hợp quan trọng.
Dữ liệu GSC có giới hạn về phạm vi báo cáo và không phải lúc nào cũng cung cấp toàn bộ lịch sử của mọi URL. Vì vậy, việc một URL không xuất hiện trong bản xuất không chứng minh URL chưa từng được Google biết đến.
Nếu vấn đề chính là URL không được lập chỉ mục, cần tách nó khỏi bài toán orphan page và thực hiện quy trình kiểm tra website không được index trước khi thay đổi cấu trúc liên kết.
Quy trình đối chiếu crawl, sitemap, GA4 và GSC
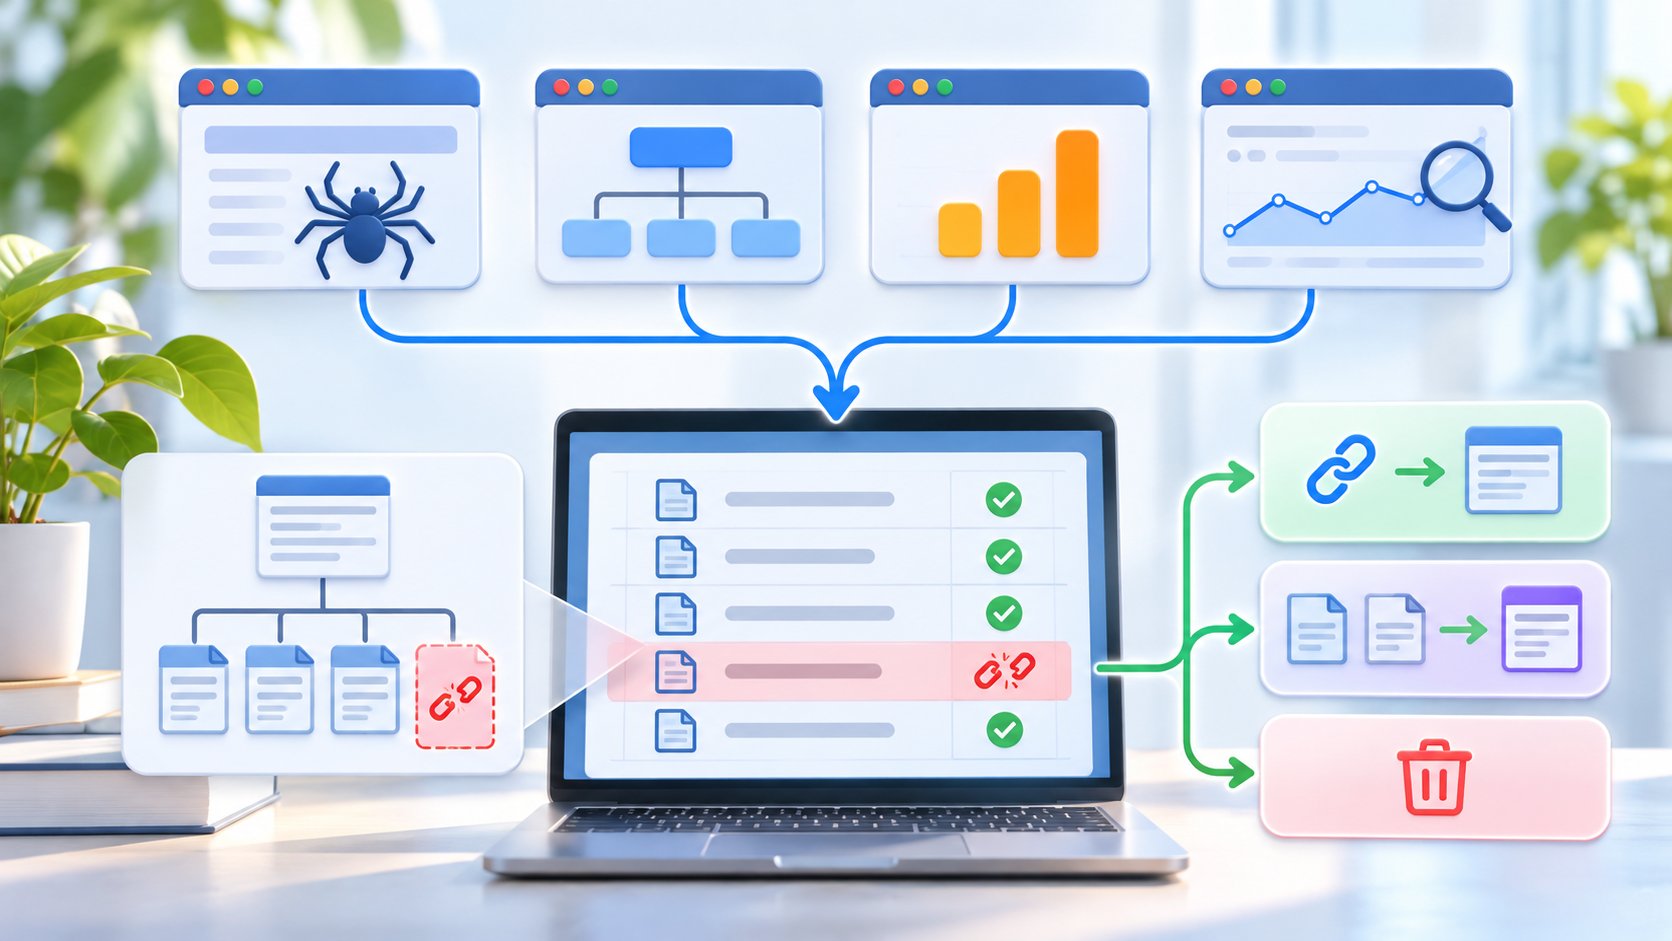
Hãy tạo một bảng URL chuẩn hóa, mỗi dòng là một URL và mỗi nguồn dữ liệu là một cột riêng. Cấu trúc tối thiểu có thể gồm:
| Trường dữ liệu | Mục đích |
|---|---|
| URL chuẩn hóa | Gộp các biến thể cùng đại diện cho một trang |
| Có trong crawl | Xác định khả năng khám phá qua liên kết nội bộ |
| Số liên kết nội bộ trỏ đến | Đánh giá mức độ kết nối của trang |
| Có trong sitemap | Kiểm tra danh sách URL website muốn cung cấp |
| Có dữ liệu GA4 | Xác định URL từng nhận truy cập |
| Có dữ liệu GSC | Xác định URL từng có hiện diện tìm kiếm |
| Mã phản hồi HTTP | Phân biệt trang hoạt động, chuyển hướng và lỗi |
| Canonical | Xác định URL đại diện được khai báo |
| Chỉ thị lập chỉ mục | Nhận diện noindex hoặc hạn chế liên quan |
| Loại và mục đích trang | Làm cơ sở ra quyết định xử lý |
Sau khi hợp nhất dữ liệu, lọc các URL không có trong tập crawl nhưng xuất hiện ở ít nhất một nguồn còn lại. Đây là danh sách ứng viên, chưa phải kết luận cuối cùng.
Với từng URL, thực hiện các bước xác minh:
- Mở URL và kiểm tra mã phản hồi thực tế.
- Xác định URL có nội dung hữu ích, còn chính xác và phù hợp mục tiêu website hay không.
- Kiểm tra canonical có tự tham chiếu hay trỏ sang URL khác.
- Kiểm tra noindex, robots.txt và các giới hạn truy cập.
- Tìm kiếm URL trong mã nguồn, nội dung đã kết xuất và cơ sở dữ liệu liên kết nội bộ.
- Xác định URL có phải biến thể tham số, bản sao hoặc trang được tạo tự động không.
- Kiểm tra dữ liệu GA4 và GSC theo thời gian để hiểu giá trị cũng như lịch sử của trang.
Nếu URL trả về trạng thái thành công nhưng nội dung gần như trống, thông báo không tìm thấy hoặc không đáp ứng ý định người dùng, cần xem xét khả năng đó là trường hợp soft 404, thay vì chỉ thêm liên kết nội bộ để trang dễ được crawl hơn.
Cách sửa trang mồ côi theo từng trường hợp
Giữ trang và thêm liên kết nội bộ
Nên giữ và liên kết lại khi trang có nội dung riêng biệt, còn chính xác, phục vụ nhu cầu người dùng và phù hợp với cấu trúc chủ đề của website.
Liên kết nên được đặt từ những trang có quan hệ ngữ nghĩa rõ ràng, chẳng hạn:
- Trang danh mục hoặc trang tổng hợp chủ đề.
- Bài viết nền tảng liên quan trực tiếp.
- Sản phẩm, dịch vụ hoặc nội dung bổ trợ.
- Khối bài viết liên quan được lựa chọn theo ngữ cảnh.
- Breadcrumb nếu trang thực sự thuộc một hệ thống phân cấp.
Anchor text cần mô tả đúng nội dung đích và được đặt tự nhiên trong câu. Không nên thêm hàng loạt liên kết ở chân trang chỉ để mọi URL đều có ít nhất một internal link. Cách đó có thể làm cấu trúc khó hiểu mà không cải thiện trải nghiệm người dùng.
Sau khi thêm liên kết, nếu trang đủ điều kiện lập chỉ mục và là URL chuẩn, có thể giữ URL trong sitemap. Sitemap và liên kết nội bộ lúc này hỗ trợ hai mục tiêu khác nhau: cung cấp danh sách URL và thể hiện mối quan hệ trong kiến trúc nội dung.
Hợp nhất với một trang khác
Nên hợp nhất khi trang mồ côi trùng hoặc gần trùng ý định tìm kiếm với một trang mạnh hơn. Quy trình phù hợp là:
- Chọn URL đích có nội dung đầy đủ và phù hợp nhất.
- Chuyển phần thông tin còn giá trị từ trang mồ côi sang trang đích.
- Thiết lập chuyển hướng vĩnh viễn nếu URL cũ không còn cần tồn tại.
- Cập nhật các liên kết, canonical và sitemap về URL đích.
- Kiểm tra chuyển hướng không tạo chuỗi hoặc vòng lặp.
Không nên hợp nhất chỉ vì hai trang có vài từ khóa giống nhau. Quyết định phải dựa trên mục đích trang, mức độ trùng lặp nội dung và nhu cầu thực tế của người đọc.
Loại bỏ URL không còn giá trị
Có thể loại bỏ khi URL là trang thử nghiệm, nội dung hết giá trị, biến thể không cần thiết hoặc không có trang thay thế tương đương.
Cách phản hồi cần phù hợp với tình trạng thực tế:
- Chuyển hướng đến trang thay thế nếu có nội dung tương đương rõ ràng.
- Trả về trạng thái không tìm thấy hoặc đã bị xóa khi trang thực sự không còn và không có trang thay thế.
- Xóa URL khỏi sitemap và các nguồn liên kết còn sót lại.
Không nên chuyển hướng mọi URL bị xóa về trang chủ. Trang chủ thường không phải nội dung thay thế tương đương, khiến người dùng không nhận được thông tin họ mong đợi.
Giữ trang nhưng không đưa vào tìm kiếm
Một số trang vẫn cần tồn tại cho người dùng nhưng không phù hợp để xuất hiện trong kết quả tìm kiếm, chẳng hạn trang phục vụ quy trình nội bộ hoặc một bước chức năng riêng. Trong trường hợp này, chủ website cần xác nhận mục đích trước khi áp dụng noindex hoặc thay đổi quy tắc thu thập dữ liệu.
Noindex không phải cách sửa orphan page. Nó chỉ xử lý khả năng lập chỉ mục, còn vấn đề trang có được kết nối hợp lý với trải nghiệm người dùng hay không vẫn cần được xem xét riêng. Không tự ý gỡ hoặc thay đổi noindex, robots.txt, nosnippet hay các giới hạn snippet khi chưa có xác nhận của chủ website.
Kiểm tra lại sau khi xử lý
Sau khi thêm liên kết, hợp nhất hoặc loại bỏ trang, hãy crawl lại website và đối chiếu lại bốn nguồn dữ liệu. Các điểm cần kiểm tra gồm:
- URL được giữ lại đã xuất hiện trong kết quả crawl hay chưa.
- Liên kết mới có thể truy cập và không bị lỗi hay không.
- URL hợp nhất có chuyển hướng đúng đến trang đích hay không.
- Sitemap chỉ còn các URL chuẩn, hoạt động và phù hợp để lập chỉ mục hay không.
- Canonical, noindex và mã phản hồi có thống nhất với quyết định xử lý không.
- URL đã xóa có còn xuất hiện trong menu, nội dung, sitemap hoặc các mẫu giao diện không.
GA4 và GSC không phản ánh thay đổi ngay lập tức theo cùng thời điểm với lần crawl nội bộ. Vì vậy, nên dùng crawl để xác nhận triển khai kỹ thuật trước, sau đó theo dõi dữ liệu tìm kiếm và truy cập theo thời gian. Không thể bảo đảm một trang sẽ được Google lập chỉ mục hoặc chọn hiển thị chỉ vì đã có liên kết nội bộ.
Những sai lầm cần tránh
- Coi mọi URL không xuất hiện trong một lần crawl là orphan page mà không kiểm tra giới hạn crawl.
- Cho rằng URL có trong sitemap thì không cần liên kết nội bộ.
- Thêm liên kết hàng loạt từ chân trang hoặc nội dung không liên quan.
- Giữ các URL tham số, bộ lọc và bản sao chỉ vì chúng xuất hiện trong GA4 hoặc GSC.
- Xóa trang đang có giá trị mà chưa kiểm tra nội dung, backlink, lượt truy cập và khả năng hợp nhất.
- Chuyển hướng tất cả URL cũ về trang chủ.
- Dùng noindex để thay thế việc tổ chức lại kiến trúc website.
- Chỉ kiểm tra index mà bỏ qua mã phản hồi, canonical và chất lượng nội dung.
Cốt lõi của việc sửa trang mồ côi không phải là buộc mọi URL nhận một liên kết. Mục tiêu là xác định URL nào thực sự cần tồn tại, kết nối các trang có giá trị vào cấu trúc hợp lý, hợp nhất nội dung trùng lặp và loại bỏ những URL không còn phục vụ người dùng.