Đối chiếu dữ liệu crawl với Search Console không nhằm xác định công cụ nào đúng hay sai. Mục tiêu là tìm ra URL mà hệ thống nội bộ có thể truy cập, URL Google đã biết và khoảng chênh lệch cần điều tra.
Công cụ crawl mô phỏng quá trình đi theo liên kết trong phạm vi cấu hình. Google Search Console phản ánh dữ liệu Google thu thập, xử lý hoặc ghi nhận theo từng báo cáo. Vì nguồn, thời điểm và phạm vi khác nhau, hai danh sách URL hiếm khi trùng khớp hoàn toàn.
Vì sao dữ liệu crawl và Search Console chênh lệch?
Trước khi so sánh dữ liệu crawl và GSC, cần hiểu mỗi nguồn đang trả lời câu hỏi nào.
Dữ liệu crawl phản ánh cấu trúc có thể truy cập
Một lượt crawl thường bắt đầu từ trang chủ, sitemap XML hoặc danh sách URL được cung cấp. Công cụ tiếp tục đi theo liên kết nội bộ và ghi nhận các tín hiệu như:
- Mã trạng thái HTTP: 200, 3xx, 404 hoặc 5xx.
- Khả năng index dựa trên robots meta, X-Robots-Tag và robots.txt.
- Canonical khai báo trong HTML hoặc HTTP header.
- Độ sâu URL và số lượng liên kết nội bộ trỏ đến trang.
- URL nguồn đã giúp phát hiện trang.
- Nội dung trùng lặp, tiêu đề, heading và các tài nguyên cần tải.
Kết quả phụ thuộc vào điểm bắt đầu, giới hạn crawl, cách xử lý JavaScript, quyền truy cập và quy tắc bao gồm hoặc loại trừ URL. Một URL không xuất hiện trong tệp crawl không đồng nghĩa Google chưa biết đến URL đó.
Search Console phản ánh dữ liệu Google đã ghi nhận
Tùy báo cáo, Search Console có thể cho biết URL đã được index, chưa được index, nhận lượt hiển thị trên Google Search, có liên kết nội bộ hoặc được khai báo qua sitemap. Nếu cần làm rõ vai trò của phần mềm SEO và Search Console, nên phân biệt dữ liệu mô phỏng quá trình thu thập với dữ liệu do Google cung cấp.
Các báo cáo trong Search Console cũng không phải một danh sách URL thống nhất:
- Báo cáo hiệu suất chủ yếu chứa URL có dữ liệu hiển thị hoặc nhấp trong khoảng thời gian được chọn.
- Báo cáo lập chỉ mục trang tập trung vào trạng thái Google đã ghi nhận.
- Báo cáo liên kết chỉ phục vụ phân tích liên kết, không phải danh sách index đầy đủ.
- Kiểm tra URL cung cấp thông tin chi tiết cho từng địa chỉ nhưng không thay thế việc xuất và phân nhóm toàn bộ website.
Giới hạn xuất, cách lấy mẫu và giao diện báo cáo có thể thay đổi. Vì vậy, cần lưu lại tên báo cáo, ngày xuất và bộ lọc đi kèm mỗi tệp.
Chuẩn bị dữ liệu trước khi đối chiếu
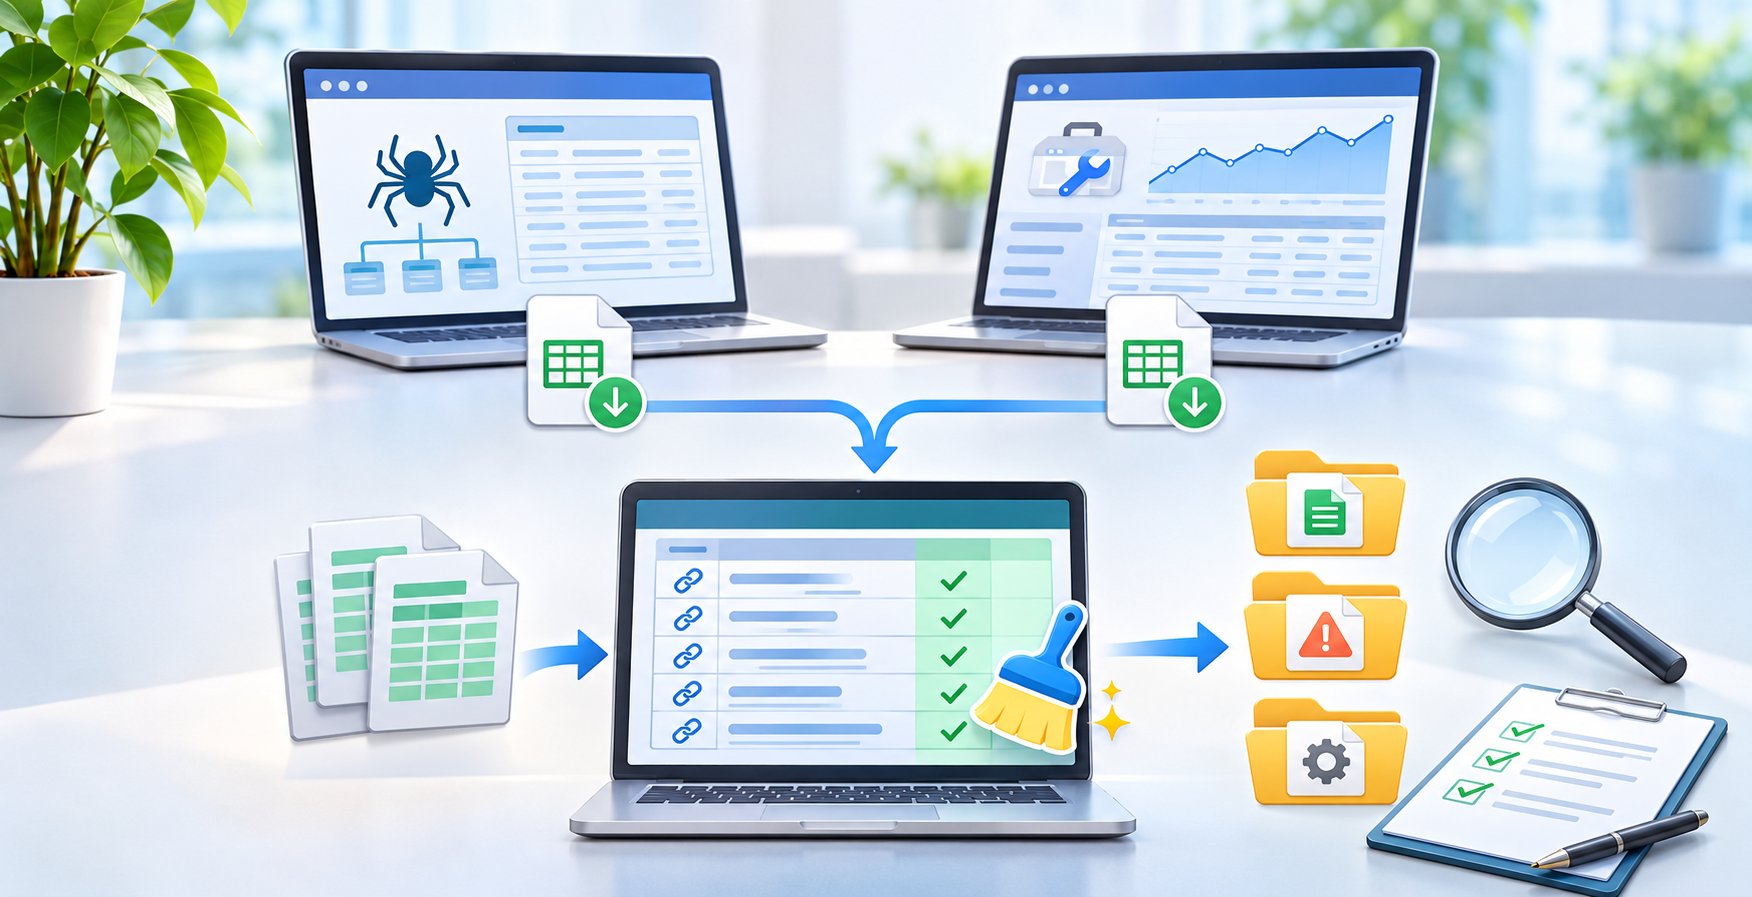
Xác định cùng một phạm vi
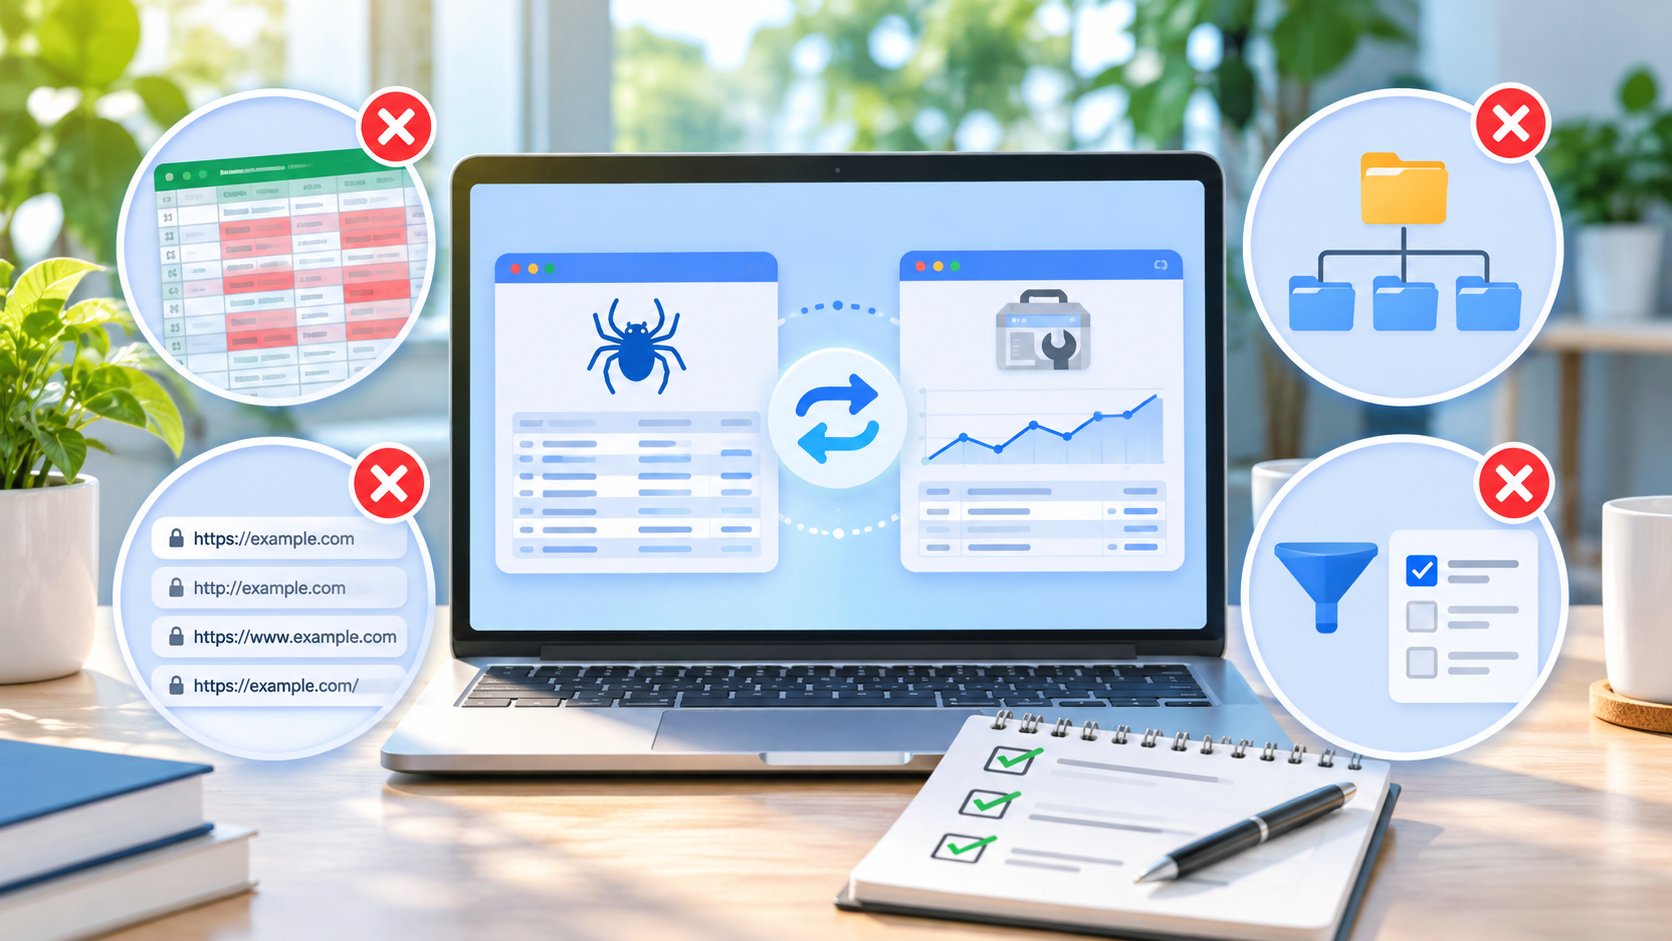
Hai tập dữ liệu chỉ có thể so sánh khi dùng cùng phạm vi. Trước khi xuất, hãy thống nhất:
- Giao thức HTTP hay HTTPS.
- Tên miền chính, tên miền phụ và phiên bản có hoặc không có
www. - Thư mục cần kiểm tra, chẳng hạn
/blog/hoặc/san-pham/. - Có đưa URL tham số, trang phân trang, tệp PDF và tài nguyên khác HTML vào hay không.
- Khoảng thời gian của báo cáo Search Console.
- Thiết bị, quốc gia và loại tìm kiếm nếu xuất từ báo cáo hiệu suất.
Nếu website vừa chuyển giao thức hoặc tên miền, cần đặc biệt kiểm tra canonical sau chuyển đổi HTTPS, thay vì gộp URL HTTP và HTTPS thành một địa chỉ ngay từ đầu.
Xuất dữ liệu crawl
Tệp crawl nên giữ ít nhất các trường sau:
| Trường | Mục đích |
|---|---|
| URL gốc | Lưu địa chỉ đúng như công cụ phát hiện |
| Content type | Tách HTML khỏi ảnh, PDF và tài nguyên khác |
| Mã trạng thái | Phân biệt URL hợp lệ, chuyển hướng và lỗi |
| Indexability | Xác định URL có đủ điều kiện index theo tín hiệu tại chỗ |
| Robots directive | Kiểm tra noindex, nofollow và X-Robots-Tag |
| Canonical khai báo | So sánh URL gốc với URL chuẩn mong muốn |
| Inlinks | Đánh giá mức độ hỗ trợ từ liên kết nội bộ |
| Crawl depth | Phát hiện trang quá sâu trong cấu trúc |
| Nguồn phát hiện | Biết URL đến từ liên kết, sitemap hay danh sách nạp vào |
Nên lưu tệp crawl gốc trước khi lọc để có thể kiểm tra lại cấu hình và bằng chứng.
Xuất dữ liệu từ Search Console
Chọn đúng property tương ứng với phạm vi website, sau đó xuất các nguồn liên quan đến câu hỏi đang điều tra:
- Báo cáo lập chỉ mục trang để lấy URL và lý do được hoặc chưa được index.
- Báo cáo hiệu suất theo trang nếu cần xác định URL từng có hiển thị hoặc lượt nhấp.
- Báo cáo liên kết nội bộ nếu mục tiêu là kiểm tra khả năng Google nhận biết cấu trúc liên kết.
- Dữ liệu sitemap để xác minh Google đã đọc tệp nào và trạng thái xử lý tương ứng.
- Kết quả kiểm tra URL cho các mẫu đại diện cần xác minh sâu.
Không nên dùng riêng báo cáo hiệu suất để kết luận một URL chưa được index. URL đã index nhưng không có lượt hiển thị trong phạm vi ngày và bộ lọc đã chọn có thể không xuất hiện trong tệp này.
Quy trình đối chiếu dữ liệu crawl với Search Console
Bước 1: Giữ nguyên cột URL gốc
Không chỉnh sửa trực tiếp URL trong tệp nguồn. Hãy tạo thêm cột normalized_url để chuẩn hóa, đồng thời giữ raw_url phục vụ truy vết.
Cách làm này giúp phát hiện những khác biệt có ý nghĩa như URL HTTP vẫn được Google ghi nhận trong khi website chỉ liên kết tới HTTPS.
Bước 2: Chuẩn hóa URL có kiểm soát
Quy tắc chuẩn hóa có thể gồm:
- Chuyển tên miền về chữ thường.
- Loại bỏ fragment bắt đầu bằng
#vì fragment thường không được gửi trong yêu cầu HTTP. - Loại bỏ cổng mặc định nếu không ảnh hưởng đến địa chỉ thực tế.
- Chuẩn hóa ký tự mã hóa tương đương một cách thận trọng.
- Sắp xếp tham số truy vấn để hỗ trợ so khớp, nhưng vẫn giữ bản gốc.
Không nên tự động xóa dấu gạch chéo cuối, tham số, giao thức hoặc tiền tố www. Trước tiên phải kiểm tra máy chủ có chuyển hướng và hợp nhất các biến thể hay không. Ví dụ, /danh-muc/ao và /danh-muc/ao/ có thể là hai URL khác nhau nếu máy chủ cùng trả về mã 200.
Nên tạo hai khóa so sánh:
- Khóa URL chính xác: giữ nguyên giao thức, tên miền, đường dẫn và tham số sau khi chuẩn hóa kỹ thuật tối thiểu.
- Khóa cụm canonical: gom các URL có cùng canonical sau khi đã xác minh tín hiệu canonical hợp lệ.
Bước 3: Gắn nhãn nguồn dữ liệu
Với mỗi URL, thêm các cột dạng có hoặc không:
- Có trong crawl.
- Có trong báo cáo lập chỉ mục.
- Có trong báo cáo hiệu suất.
- Có trong sitemap.
- Có liên kết nội bộ được ghi nhận.
Không nên tạo một cột chung mang tên có trong GSC, vì URL xuất hiện trong báo cáo hiệu suất có ý nghĩa khác với URL xuất hiện trong báo cáo chưa được index.
Bước 4: Ghép dữ liệu theo URL chuẩn hóa
Thực hiện phép ghép đầy đủ giữa tệp crawl và các tệp Search Console. Kết quả nên giữ cả URL chỉ có ở một phía.
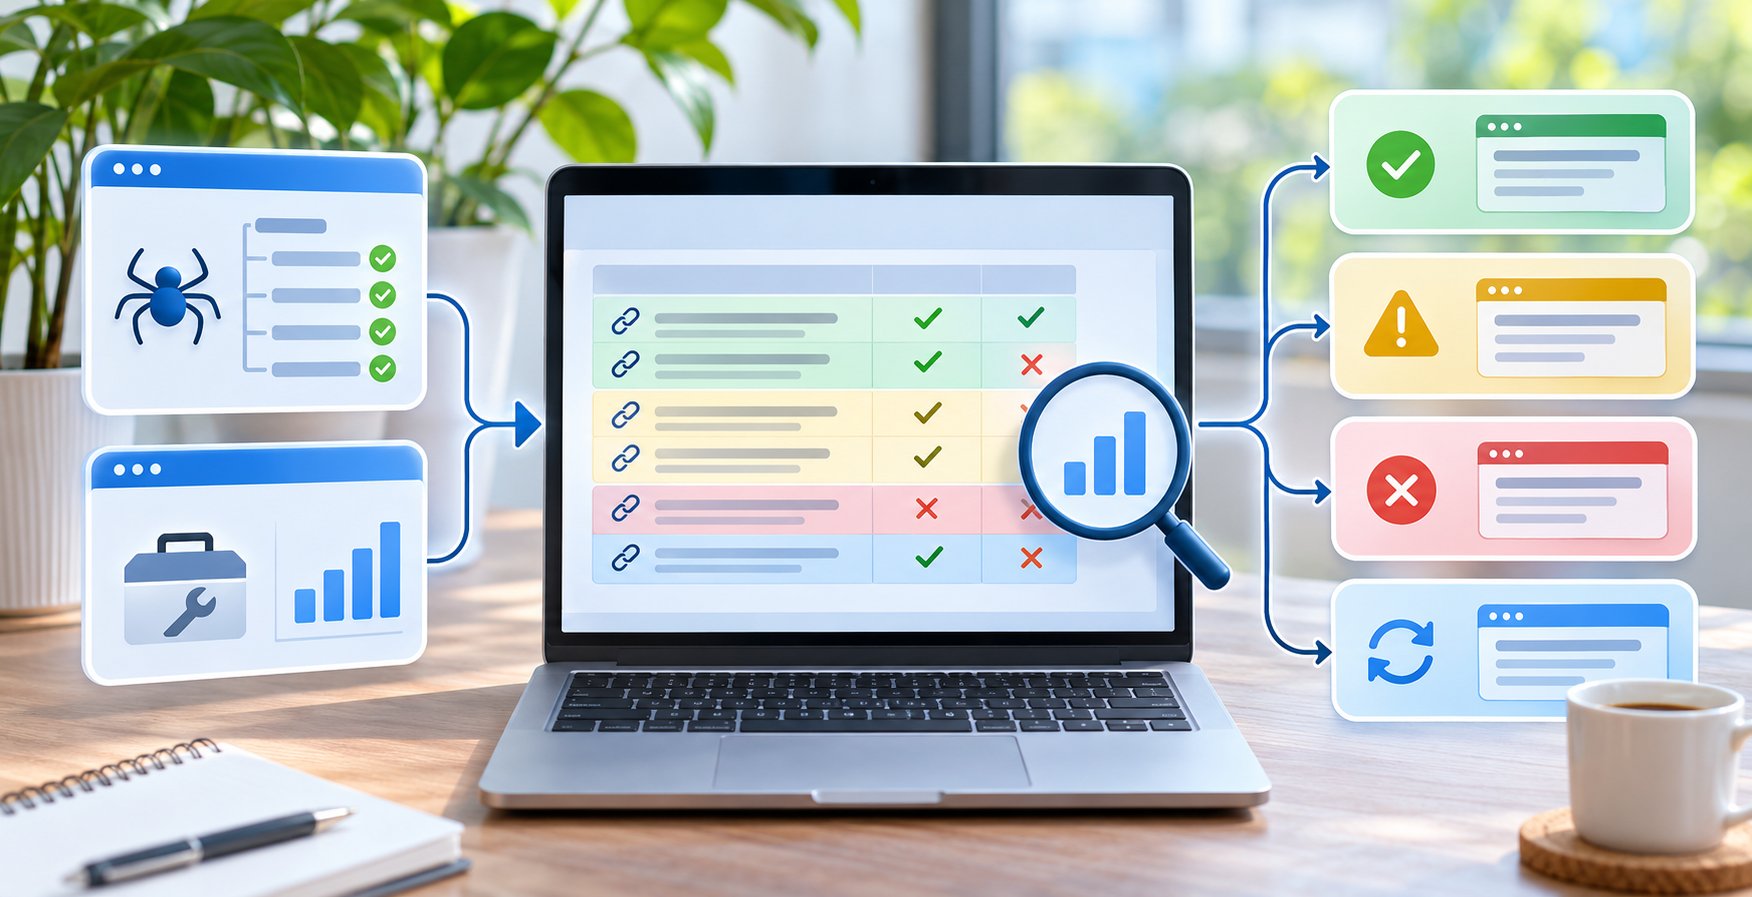
Có thể phân thành bốn nhóm chính:
| Nhóm | Ý nghĩa ban đầu |
|---|---|
| Có trong cả hai nguồn | URL được crawl nội bộ và Google đã ghi nhận trong báo cáo đang xét |
| Có trong GSC nhưng không crawl thấy | Google biết URL từ nguồn khác hoặc lượt crawl hiện tại không tiếp cận được |
| Crawl thấy nhưng không có trong GSC | URL có trên website nhưng chưa xuất hiện trong báo cáo đã chọn |
| Cùng nội dung nhưng URL khác | Có thể liên quan đến canonical, chuyển hướng, tham số hoặc chuẩn hóa sai |
Bước 5: Lấy mẫu xác minh
Không cần kiểm tra thủ công mọi URL ngay từ đầu. Hãy nhóm theo mẫu đường dẫn, trạng thái và nguyên nhân, sau đó chọn URL đại diện cho từng cụm.
Ví dụ, nếu phần lớn URL chênh lệch nằm trong /bo-loc/, hãy kiểm tra mẫu tham số và quy tắc tạo liên kết của cả thư mục. Nếu chênh lệch tập trung ở /bai-viet/, cần xem template bài viết, phân trang danh mục và liên kết từ trang chủ.
Với các URL quan trọng, dùng kiểm tra URL để đối chiếu:
- Trạng thái index hiện tại.
- Lần thu thập gần nhất được báo cáo.
- Canonical do website khai báo.
- Canonical Google lựa chọn, nếu có.
- Khả năng truy cập và tài nguyên cần thiết.
Kết quả kiểm tra trực tiếp chỉ mô tả khả năng truy cập tại thời điểm kiểm tra, không bảo đảm URL sẽ được index hoặc thay thế trạng thái đã lưu trong chỉ mục.
Cách phân tích từng nhóm URL chênh lệch
URL có trong GSC nhưng không crawl thấy
Đây là nhóm thường gây hiểu nhầm nhất. Các nguyên nhân phổ biến gồm:
- Không có liên kết nội bộ: Google có thể biết URL từ sitemap, liên kết ngoài hoặc dữ liệu lịch sử, trong khi crawler bắt đầu từ trang chủ không tìm thấy đường đi.
- URL cũ vẫn còn trong dữ liệu: Trang đã bị xóa hoặc chuyển hướng sau lần Google thu thập trước đó.
- Cấu hình crawl loại trừ URL: Thư mục, tham số hoặc loại nội dung bị loại khỏi phạm vi.
- JavaScript tạo liên kết: URL chỉ xuất hiện sau khi trình duyệt thực thi mã, còn lượt crawl không render JavaScript.
- Crawler bị chặn: robots.txt, xác thực, tường lửa hoặc cơ chế giới hạn truy cập ngăn công cụ thu thập.
- URL chỉ tồn tại trong sitemap: Sitemap chứa địa chỉ không còn liên kết từ cấu trúc điều hướng.
- Khác biệt property: Tệp GSC thuộc property tên miền, còn crawl chỉ chạy trên một tên miền phụ.
- Canonical và URL biến thể: Dữ liệu hiệu suất có thể được quy về URL canonical, trong khi crawl ghi nhận URL được liên kết thực tế.
Quy trình kiểm tra nên bắt đầu từ mã trạng thái hiện tại, robots, canonical, sitemap và liên kết nội bộ. Nếu URL quan trọng không còn đường dẫn nội bộ, cần bổ sung liên kết từ trang liên quan thay vì chỉ gửi lại sitemap.
Crawl thấy nhưng không có trong GSC
Một URL được crawl thấy chỉ chứng minh crawler có thể phát hiện nó trong cấu hình hiện tại. URL chưa xuất hiện trong tệp Search Console có thể do:
- Trang mới được tạo và Google chưa xử lý.
- URL trả về 200 nhưng có
noindex. - URL bị chặn thu thập hoặc cần đăng nhập.
- URL canonical sang một địa chỉ khác.
- Nội dung trùng lặp hoặc có giá trị tìm kiếm thấp.
- URL là chuyển hướng, lỗi mềm hoặc lỗi máy chủ.
- Google chưa phát hiện URL qua liên kết và sitemap.
- URL đã index nhưng không có dữ liệu trong báo cáo hiệu suất được xuất.
- Báo cáo hoặc tệp xuất không bao phủ toàn bộ URL cần so sánh.
Nếu URL thuộc nhóm trang kinh doanh hoặc nội dung chính, hãy làm theo quy trình kiểm tra và xử lý trang không được index. Không nên yêu cầu index hàng loạt trước khi xử lý nguyên nhân kỹ thuật và chất lượng nội dung.
URL xuất hiện ở cả hai nguồn nhưng trạng thái khác nhau
Một số trường hợp crawler ghi nhận URL indexable, còn Search Console báo chưa được index hoặc chọn canonical khác. Đây không nhất thiết là lỗi dữ liệu.
Crawler đánh giá tín hiệu hiện tại của website. Search Console có thể phản ánh lần xử lý trước đó hoặc quyết định của Google dựa trên nhiều tín hiệu ngoài trang, gồm liên kết, sitemap, nội dung trùng lặp và lịch sử URL.
Cần kiểm tra:
- Trang có mới thay đổi robots hoặc canonical hay không.
- Google đã thu thập lại sau thay đổi chưa.
- Canonical khai báo có nhất quán với redirect, sitemap và liên kết nội bộ không.
- URL canonical có trả về 200 và có thể index không.
- Các biến thể URL có nội dung thực sự tương đương không.
Chênh lệch do tham số và bộ lọc
URL bộ lọc có thể tạo nhiều tổ hợp đường dẫn hoặc tham số. Crawler chỉ phát hiện các tổ hợp được liên kết, trong khi Google có thể lưu URL từ lịch sử hoặc liên kết ngoài. Trường hợp này cần kiểm tra nguy cơ index bloat do URL bộ lọc, thay vì cố làm cho hai danh sách khớp tuyệt đối.
Hãy xác định rõ nhóm URL nào có giá trị tìm kiếm, nhóm nào chỉ phục vụ người dùng và nhóm nào không nên được tạo. Sau đó đồng bộ liên kết nội bộ, canonical, robots và sitemap theo cùng mục tiêu.
Ưu tiên xử lý chênh lệch URL SEO
Không phải mọi chênh lệch đều cần sửa. Có thể ưu tiên theo mức độ ảnh hưởng như sau:
Ưu tiên cao
- Trang sản phẩm, dịch vụ hoặc nội dung chính có trong GSC nhưng không thể crawl từ cấu trúc nội bộ.
- URL cần index nhưng crawler phát hiện
noindex, canonical sai hoặc mã trạng thái không phải 200. - Sitemap chứa URL lỗi, chuyển hướng hoặc URL không phải canonical.
- Google chọn canonical khác với URL doanh nghiệp muốn xếp hạng.
- Nhiều URL tham số được index ngoài chủ đích.
Ưu tiên trung bình
- Trang hợp lệ nhưng nằm quá sâu và có rất ít liên kết nội bộ.
- URL mới chưa xuất hiện trong Search Console nhưng đã có sitemap và liên kết phù hợp.
- Dữ liệu giữa các báo cáo GSC chưa đồng nhất do khác thời điểm cập nhật.
Có thể chấp nhận
- URL đăng nhập, giỏ hàng hoặc trang chức năng không cần index.
- URL chuyển hướng cũ vẫn xuất hiện trong dữ liệu lịch sử.
- Biến thể tham số phục vụ đo lường nhưng đã được kiểm soát.
- URL không có lượt hiển thị trong báo cáo hiệu suất nhưng trạng thái index vẫn bình thường.
Một bảng công việc đối soát dữ liệu technical SEO nên có các cột: nhóm URL, mẫu đường dẫn, mức ưu tiên, nguyên nhân giả định, bằng chứng, hành động, người phụ trách và ngày kiểm tra lại. Nguyên nhân chỉ nên được xác nhận sau khi có bằng chứng từ phản hồi máy chủ, mã nguồn, sitemap và Search Console.
Những sai lầm cần tránh khi đối soát dữ liệu
Mặc định một nguồn bị sai
Mỗi nguồn quan sát website theo cách khác nhau. Việc hai danh sách không trùng không đủ để kết luận dữ liệu thiếu chính xác. Cần đánh giá độ chính xác của dữ liệu SEO dựa trên định nghĩa chỉ số, phạm vi, cấu hình và thời gian thu thập.
Gộp URL quá sớm
Nếu xóa tham số, giao thức hoặc dấu gạch chéo cuối trước khi kiểm tra phản hồi máy chủ, quá trình chuẩn hóa có thể che giấu lỗi trùng lặp và canonical.
So sánh các báo cáo khác mục đích
Danh sách URL crawl toàn website không thể so sánh trực tiếp với danh sách trang có lượt hiển thị rồi kết luận phần còn lại chưa index. Hãy dùng báo cáo lập chỉ mục cho câu hỏi về index và báo cáo hiệu suất cho câu hỏi về khả năng xuất hiện trên kết quả tìm kiếm.
Bỏ qua thời điểm thu thập
Tệp crawl hôm nay và dữ liệu Google được ghi nhận từ trước có thể phản ánh hai phiên bản khác nhau của website. Luôn lưu ngày crawl, ngày xuất GSC và ngày triển khai thay đổi kỹ thuật.
Chỉ kiểm tra từng URL riêng lẻ
Kiểm tra thủ công hữu ích cho xác minh, nhưng sửa từng URL sẽ kém hiệu quả nếu lỗi đến từ template, menu, bộ lọc hoặc quy tắc canonical. Hãy nhóm theo mẫu đường dẫn và nguyên nhân để xử lý ở cấp hệ thống.
Câu hỏi thường gặp
URL có trong GSC nhưng không crawl thấy có phải là URL mồ côi không?
Chưa chắc. URL có thể không có liên kết nội bộ, nhưng cũng có thể bị loại bởi cấu hình crawl, chỉ xuất hiện sau khi render JavaScript hoặc thuộc tên miền phụ ngoài phạm vi. Chỉ nên xác nhận URL mồ côi sau khi crawl đầy đủ cấu trúc, kiểm tra sitemap và xem nguồn liên kết.
URL không có trong báo cáo hiệu suất có nghĩa là chưa index không?
Không. Báo cáo hiệu suất chỉ phản ánh dữ liệu tìm kiếm trong khoảng thời gian và bộ lọc đã chọn. Cần kiểm tra báo cáo lập chỉ mục hoặc kiểm tra URL để đánh giá trạng thái index.
Có nên làm cho danh sách crawl và Search Console khớp hoàn toàn?
Không cần. Mục tiêu là giải thích được phần chênh lệch và xử lý các URL ảnh hưởng đến khả năng thu thập, index hoặc hiệu suất tìm kiếm. URL lịch sử, trang chức năng và biến thể đã được kiểm soát có thể xuất hiện ở một nguồn mà không cần sửa.
Bao lâu nên đối chiếu lại dữ liệu?
Nên kiểm tra sau các thay đổi lớn như chuyển tên miền, thay cấu trúc URL, cập nhật template, sửa canonical hoặc thay hệ thống liên kết nội bộ. Với website thường xuyên xuất bản hoặc thay đổi sản phẩm, có thể thực hiện định kỳ theo nhịp vận hành thay vì chờ đến khi traffic giảm.
Kết quả đối chiếu tối thiểu cần có gì?
Kết quả nên trả lời được ba câu hỏi: URL nào chênh lệch, vì sao chênh lệch và hành động nào cần thực hiện. Một bảng chỉ liệt kê URL mà không có trạng thái HTTP, canonical, nguồn phát hiện, phạm vi báo cáo và mức ưu tiên sẽ khó hỗ trợ quyết định technical SEO.